本文阅读时长:约 4 分钟
OCR 智能采集
OCR(光学字符识别,即从图片中识别文字)用于辅助处理源文件中的内容。本页说明相关设置和人工核对要求;文件上传、自动处理、表单提交与质量核查应分别确认。
能力总览
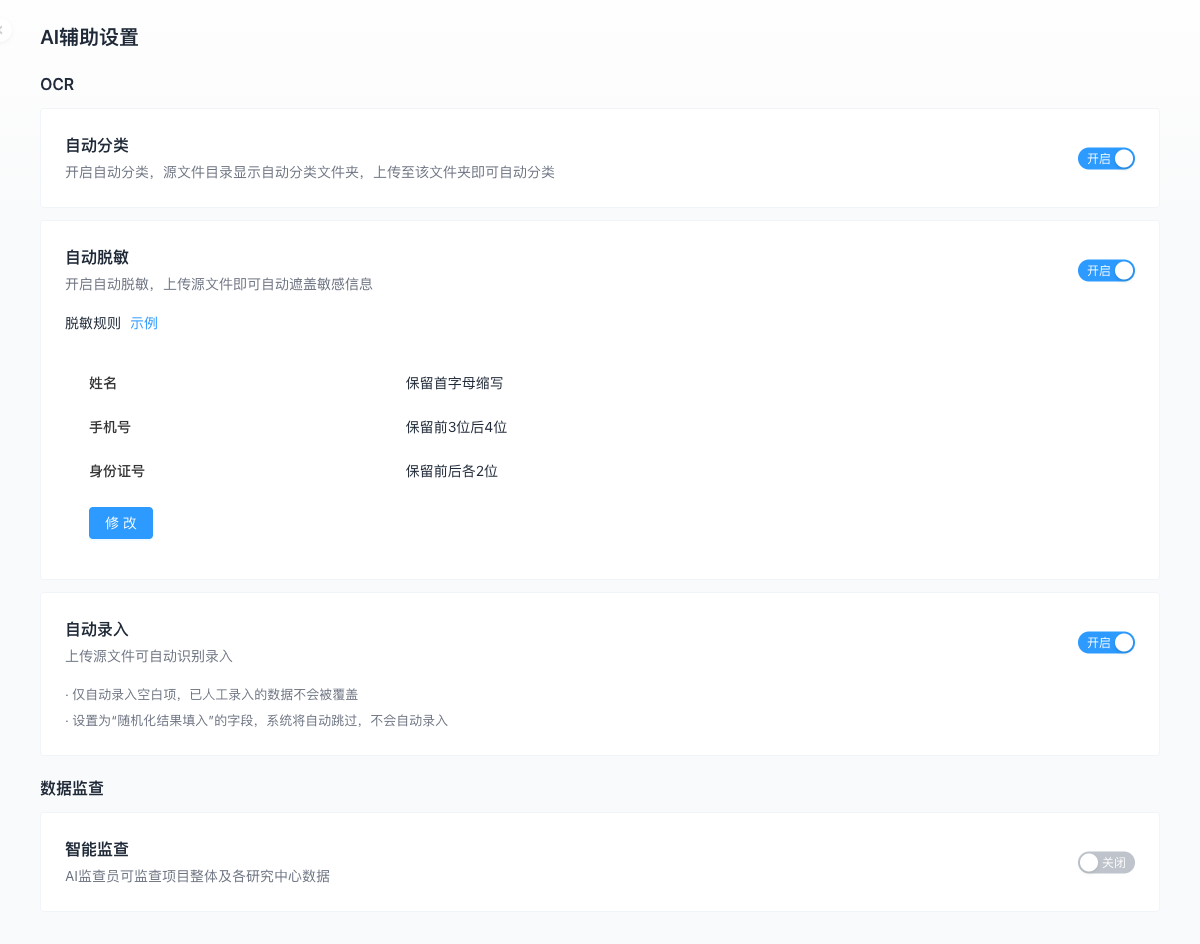
项目的“AI辅助设置”提供自动分类、自动脱敏和自动录入说明。使用前,先确认源文件目录、事件关联和相应设置,再使用模拟资料验证实际结果。
| 环节 | 核对内容 | 相关章节 |
|---|---|---|
| 采集准备 | 源文件功能、事件、分类和文件夹均可用 | 源文件配置 |
| 图片上传 | 材料完整、可预览,归属于正确记录 | 源文件上传 |
| 自动处理 | 分类、脱敏和字段值逐项符合原始依据 | 本页各节 |
| 结果使用 | 人工核对后完成表单提交及后续核查 | 数据录入 |
上传成功或开关已开启,不足以证明该图片已完成识别、分类或脱敏。不能将设置说明视为每次处理均成功的承诺。
文本识别与字段提取
自动录入的设置说明为:只填充空白字段,不覆盖人工录入的已有内容,并跳过设置为“随机化结果填入”的字段。字段没有变化时,应先核对这些条件,不为触发识别而清空已经核对的数据。
已显示在表单中的值,需要与原图和字段定义对照:
| 核对对象 | 核对要求 |
|---|---|
| 数据位置 | 中心、研究参与者、事件和表单均与材料一致 |
| 字段含义 | 同名项目、检查日期和重复记录未混用 |
| 数值与单位 | 数字、小数位、正负号、单位和必要换算均有依据 |
| 日期与空值 | 日期含义清楚,未知、不适用和零分别处理 |
无法辨认的内容应补充清晰资料。识别值与原图不一致时,按原始依据更正;已提交数据的修改按页面要求说明原因,再核对字段历史,见数据录入。
图片分类与路由
自动分类开启后,目录中显示“自动分类”文件夹;上传至该文件夹才触发分类处理。上传至其他文件夹后没有自动分类,不能直接判断为故障。
文件处理后,应核对实际事件、分类和文件夹。目录名称与材料类型相近,不足以确认归属正确;还需检查研究参与者、事件时间和图片内容。文件归属与表单字段值分别核对。
分类错误或材料重复时,按源文件管理核实后处理。移动、复制和删除前确认目标目录、选择数量及材料依据,不通过多次上传代替分类核对。
智能脱敏
自动脱敏按当前项目规则处理敏感信息。规则可以修改,应以本项目设置为准,不将演示规则当作所有研究的统一要求。
核对时同时检查身份信息是否遗漏,以及检查日期、数值、单位和结论是否被误遮挡。自动处理后仍有遗漏时,由具备权限的成员完成人工脱敏,并再次检查结果。
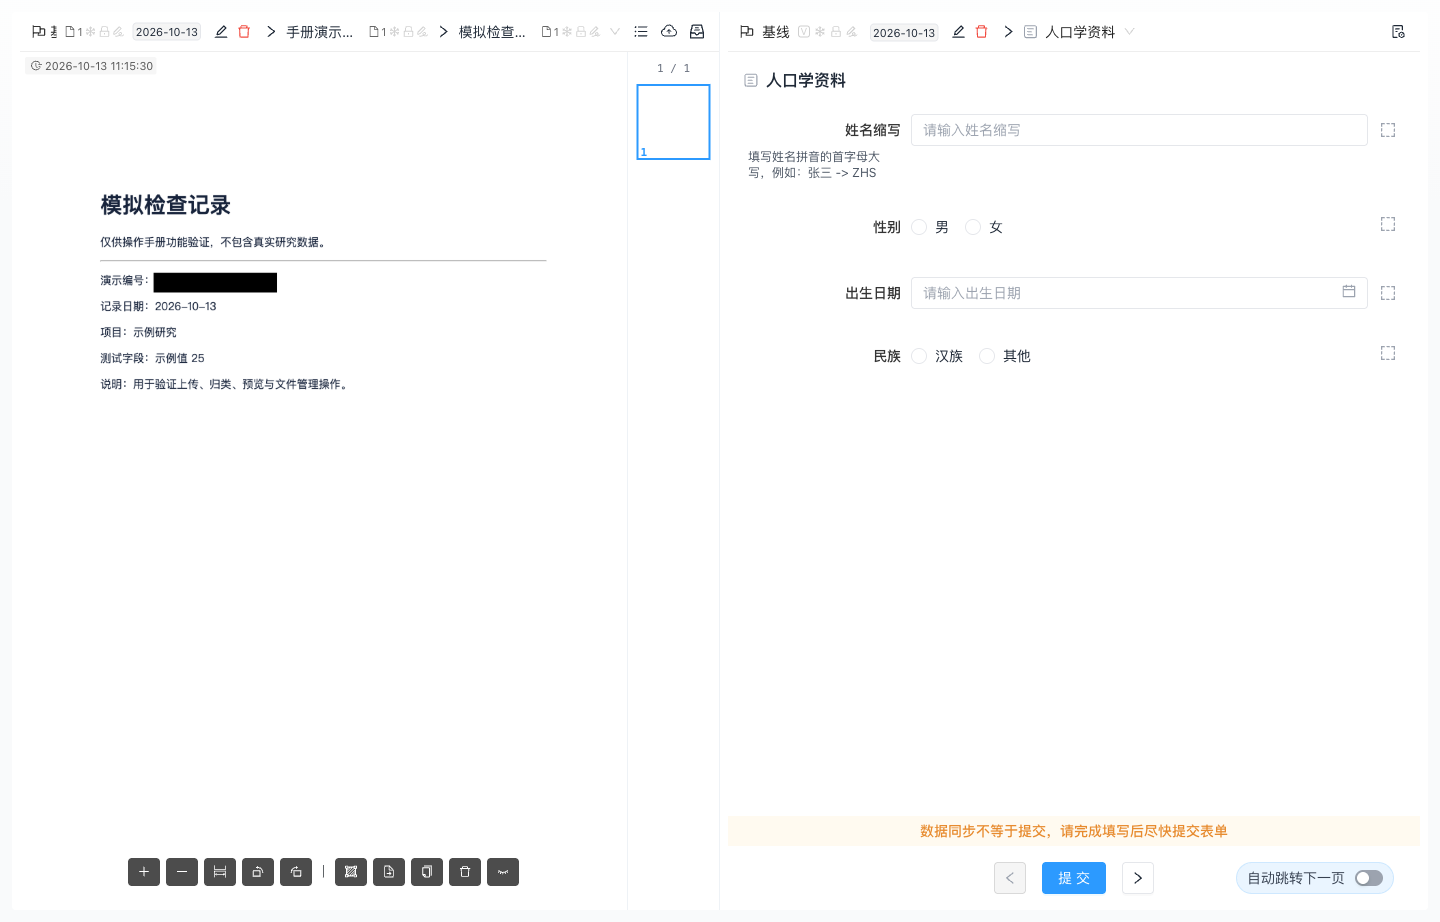
人工脱敏的实际操作见方向和人工脱敏。脱敏只用于隐私处理,不能修改研究数值或检查结论;不要把保存前的撤销功能理解为保存后可以恢复原图的保证。
质量与真实性检测
材料质量仍需人工检查。图片可以预览、经过识别或已经脱敏,均不足以证明材料完整、清晰或真实。
| 检查内容 | 处理要求 |
|---|---|
| 清晰度与方向 | 数值、单位和日期应可辨认;旋转不能修复模糊内容 |
| 完整性 | 检查缺页、裁切和遮挡,缺少依据时补充材料 |
| 归属一致性 | 核对研究参与者、事件及材料日期,不只查看文件名 |
| 内容可信性 | 结合原始记录和项目核查要求判断,不以自动处理结果代替 |
需要对数据与原始依据的一致性作出确认时,按项目范围执行源数据核查(即对照原始记录核对录入值),具体方法见源数据核查功能页。材料真实性仍需结合原始记录和项目核查要求判断。
人工核对与采纳
经核对的数据才能用于研究记录。采纳识别结果前,应确认原图可核对、文件归属正确、字段含义及数值一致,且脱敏未遮挡所需依据。
- 对已有人工值,保留其原始依据,不为使自动录入生效而清空。
- 对不一致或无法确认的值,先核对材料,再更正或补充说明。
- 对表单中的最终值,检查同步与提交结果;数据已同步不等于已提交。
- 对已提交后的变更,检查相关质疑、核查标记和签名是否需要重新处理。
文件已有字段关联、字段已有值或表单已提交,都不能代替质量核查。后续处理见数据标记与锁定。